
El seguimiento de ingresos de apps casi nunca falla de forma ruidosa. Sin error, sin alerta, sin banner rojo en un dashboard. Falla en silencio: un evento sigue disparándose mientras su valor marca cero sin hacer ruido, un pipeline sigue funcionando mientras su gemelo descarta ingresos, y Smart Bidding sigue gastando contra números que dejaron de significar algo.
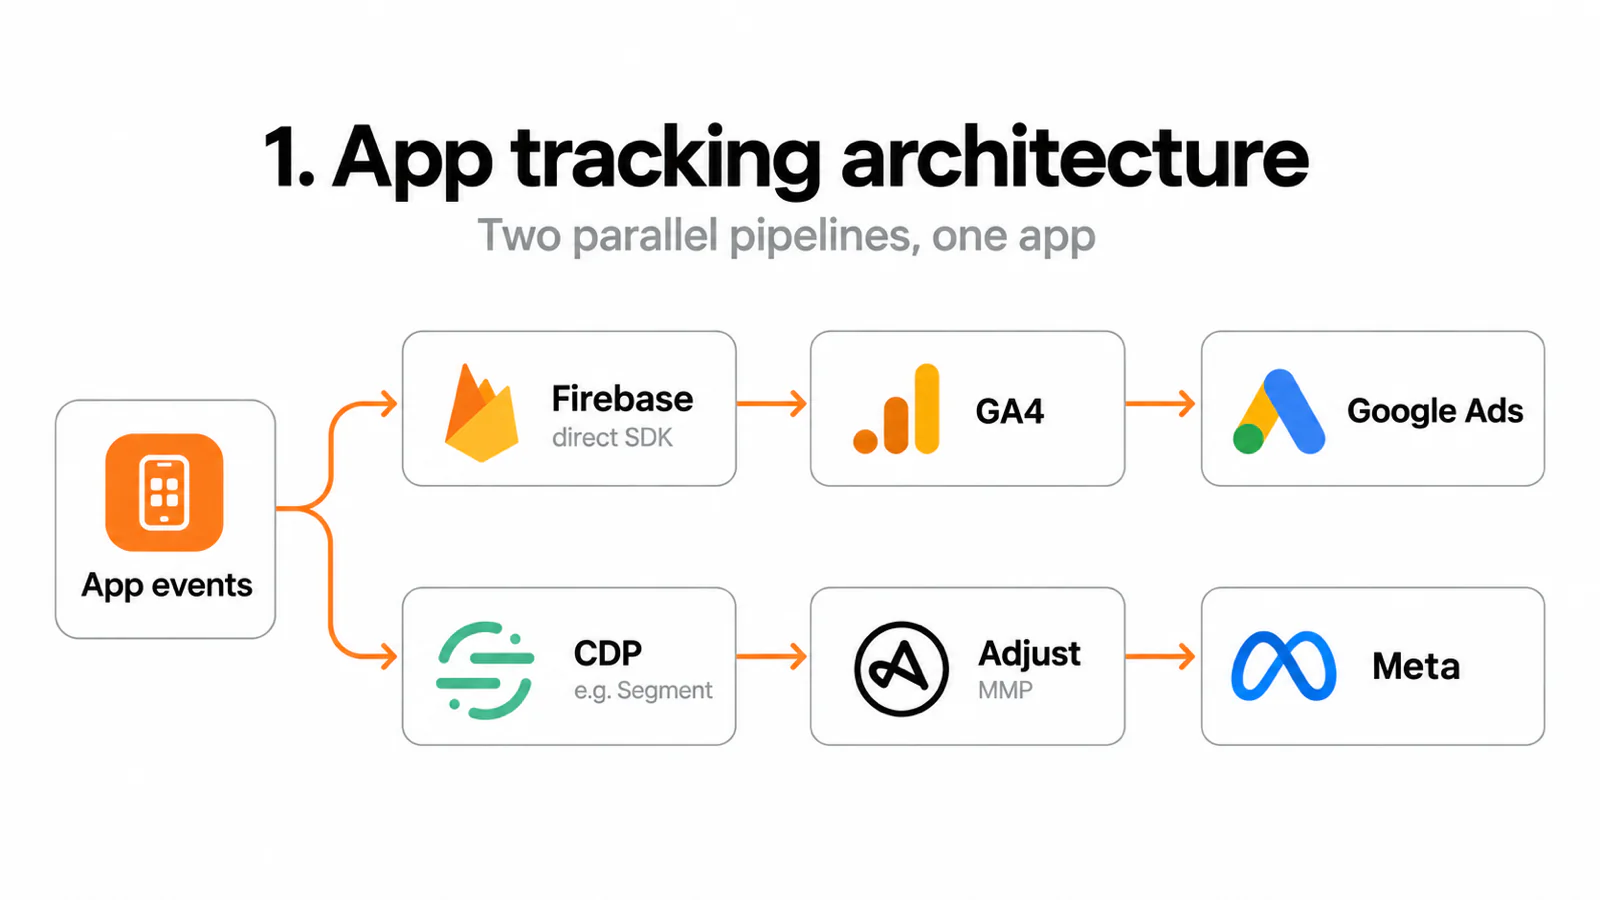
Lo sé porque envié a producción cada uno de los fallos de este post. Todos provienen de un stack real que gestiono para un marketplace de reservas suizo: una app React Native, Firebase directo a GA4 y Google Ads, Adjust vía una plataforma de datos de clientes a Meta.
Este es el segundo post de una serie de tres partes sobre seguimiento de apps. La primera parte cubrió la arquitectura de doble stack y quién alimenta qué: por qué una sola herramienta no basta y cómo funcionan en paralelo los pipelines de Firebase y del MMP. Este es el catálogo de fallos: cinco formas en que ese stack se rompe sin avisarte, y la monitorización que habría detectado cada una antes de lo que yo lo hice. La tercera parte cubre el hueco de atribución en iOS que oculta conversiones de app a Google Ads.
En resumen
- Los cinco fallos silenciosos: leer la métrica de GA4 equivocada, eventos que se disparan sin parámetros de valor, uno de dos pipelines que descarta ingresos, valores de conversión predeterminados planos y eventos muertos que nadie nota.
- Ninguno produce un error. Todos corrompen las pujas, porque las plataformas optimizan hacia los números que llegan, sean cuales sean.
- Cada fallo tiene una detección barata: una conciliación semanal de ingresos entre Firebase, el MMP y el backend, una comprobación de actualidad por evento y una comprobación de cobertura de valor en ambos pipelines.
- La regla incómoda: que llegue el nombre de un evento no es prueba de que llegara su valor. Verifica los valores por separado, en cada pipeline.
Fallo 1: la métrica que miente por diseño
La primera vez que comprobamos los ingresos de la app en GA4, la respuesta fue 0,00. Cada evento de reserva, cero ingresos. Dimos por hecho que la implementación estaba rota.
La mitad era otra cosa: GA4 tiene dos métricas de ingresos que se comportan de forma distinta. “Ingresos totales” solo cuenta nombres de evento estándar como purchase o in_app_purchase. Nuestros eventos de reserva usaban nombres personalizados, y los eventos con nombre personalizado informan su dinero bajo “Valor del evento”, no “Ingresos totales”. Los ingresos sí llegaban; estábamos leyendo la métrica que está definida para ignorarlos.
No es un bug, es una regla de nomenclatura, y está documentada. Pero nadie lee la definición de una métrica que muestra un cero plausible. Perdimos días con esto.
La comprobación: para eventos de conversión con nombre personalizado, crea informes sobre “Valor del evento”. Reserva “Ingresos totales” para nombres de evento de ecommerce estándar. Escríbelo en la especificación de tu dashboard para que la siguiente persona no tenga que redescubrirlo.
Fallo 2: los eventos que de verdad no enviaron nada
La otra mitad de ese cero era real. En el momento de la auditoría, la app disparaba más de 200 eventos distintos, y los eventos con valor entre ellos no llevaban ningún parámetro de valor. Las reservas se disparaban como señales desnudas: las plataformas sabían que algo había pasado, pero no cuánto valía.
La consecuencia es peor que un reporting incompleto. Google y Meta pujan sobre valores. Un flujo de eventos sin valores fuerza pujas por volumen: cada conversión cuenta como una, así que el algoritmo caza las conversiones más baratas que encuentra, y una reserva de alto valor le vale exactamente lo mismo que una trivial. Cubrí la versión web de esto en el post sobre valores de conversión dinámicos; en apps la mecánica es idéntica, solo que más fácil de equivocar dos veces, porque hay dos pipelines.
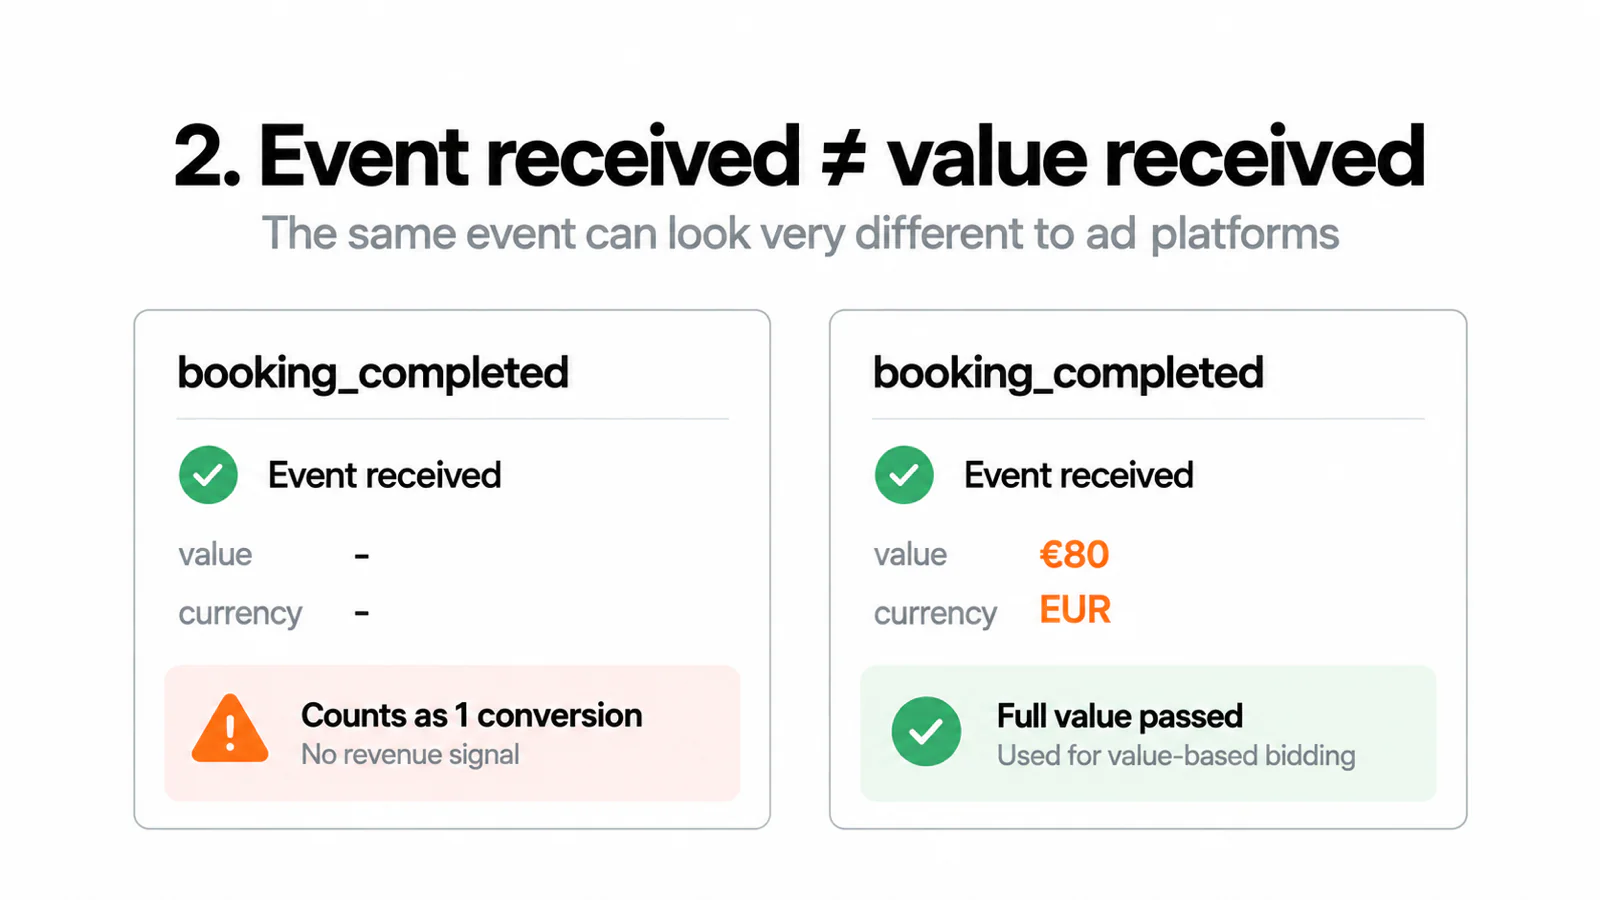
La comprobación: para cada evento con valor, en cada pipeline, confirma que los parámetros de valor y moneda están presentes en el tráfico real. La cobertura de eventos y la cobertura de valor son auditorías distintas.
Fallo 3: dos pipelines, uno roto en silencio
Este es el caro. Después de que ingeniería enviara el arreglo del valor, los ingresos de Firebase funcionaban: valores de reserva reales, fluyendo a GA4 y Google Ads. El pipeline de Adjust (el MMP) recibía los mismos eventos, de las mismas acciones de usuario, en los mismos días, y capturaba aproximadamente un octavo de los ingresos que veía Firebase. Luego cayó a cero mientras Firebase seguía registrando dinero.
Nada dio error. La causa vivía en la fontanería del segundo pipeline: la app enviaba eventos al MMP a través de una plataforma de datos de clientes, y la llamada de ingresos tenía modos de fallo que la llamada directa de Firebase no tenía. Un helper de precio que devolvía null para algunos tipos de reserva convertía los ingresos en NaN. Un campo de ingresos que llegaba como string en vez de número. Una etiqueta de moneda que no era exactamente el código ISO que el SDK esperaba. Cada uno de estos hace que un SDK de MMP se salte en silencio la adición de ingresos: el evento igual llega, con aspecto sano, sin valer nada.
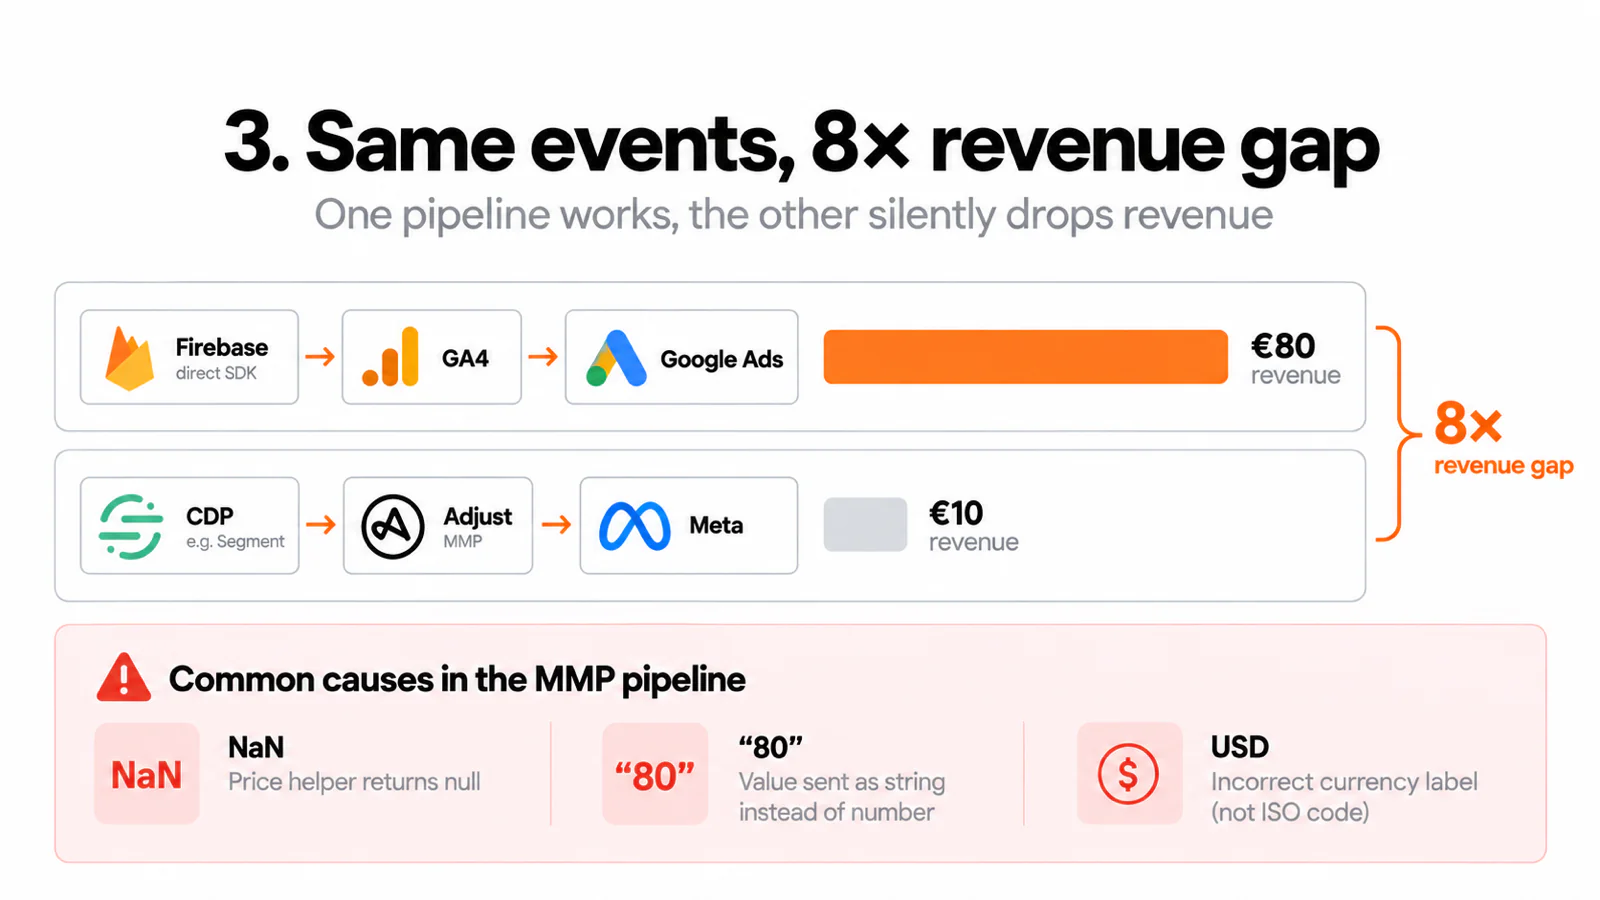
Como el MMP era nuestra única vía de conversión hacia Meta, esto significaba que Meta optimizaba sobre valores vacíos mientras Google optimizaba sobre valores reales, y la diferencia era invisible en cada plataforma por separado.
La comprobación: concilia los ingresos entre Firebase, el MMP y tu backend cada semana, con una tolerancia que fijes de antemano. Los tres nunca coincidirán exactamente. Pero una diferencia de 8x no es un matiz de atribución, es un bug de ingresos descartados, y solo una comparación entre fuentes lo saca a la luz. Cuando lo encuentres, depura con una línea de log antes de la llamada al SDK: el tipo y el valor de los ingresos y la moneda. NaN, undefined, "NaN" como string, o una etiqueta de moneda no ISO es tu bug.
Fallo 4: el valor predeterminado plano
Mientras los valores estaban rotos, las acciones de conversión de Google Ads recurrían a un valor predeterminado de 1,00. El valor medio real de reserva era aproximadamente 11 veces mayor.
Un valor predeterminado equivocado es peor de lo que suena, porque no parece equivocado. Las conversiones fluyen, los dashboards se llenan, el cálculo del ROAS corre. Pero el algoritmo de pujas está optimizando contra números que se desvían en un orden de magnitud, y cada decisión de presupuesto automatizada hereda la distorsión. Cuando arreglamos el pipeline, también subimos el valor predeterminado para que cualquier hueco futuro al menos fallara hacia números realistas en vez de hacia 1,00.
La comprobación: abre cada acción de conversión de app en Google Ads y lee tres ajustes: el valor (predeterminado vs dinámico), si la acción es principal o secundaria, y la ventana de atribución. Los valores predeterminados se fijan una vez, normalmente durante un sprint de configuración, y luego sobreviven años sin que nadie los revise.
Fallo 5: el evento que murió y nadie se dio cuenta
Un evento de conversión, un registro del lado de la oferta que nos importaba, dejó de llegar por completo. Para cuando una auditoría lo detectó, llevaba muerto más de dos meses. No existía ninguna alerta, porque los pipelines de eventos no alertan; simplemente se detienen.
Todo setup de seguimiento se degrada. Las releases de la app renombran cosas, las actualizaciones de SDK cambian el comportamiento, un refactor elimina una llamada. La pregunta no es si un evento morirá, sino cuánto tiempo permanece muerto antes de que alguien lo note. Dos meses de una señal de conversión ausente son dos meses de una plataforma aprendiendo mal lo que hacen tus usuarios.
La comprobación: una alarma de actualidad por evento. La versión más simple es una mirada semanal a los días-desde-el-último-evento para cada evento de conversión, en ambos pipelines. Cualquier cosa por encima de unos pocos días en un evento que debería dispararse a diario es un incidente, no una curiosidad.
La checklist de monitorización
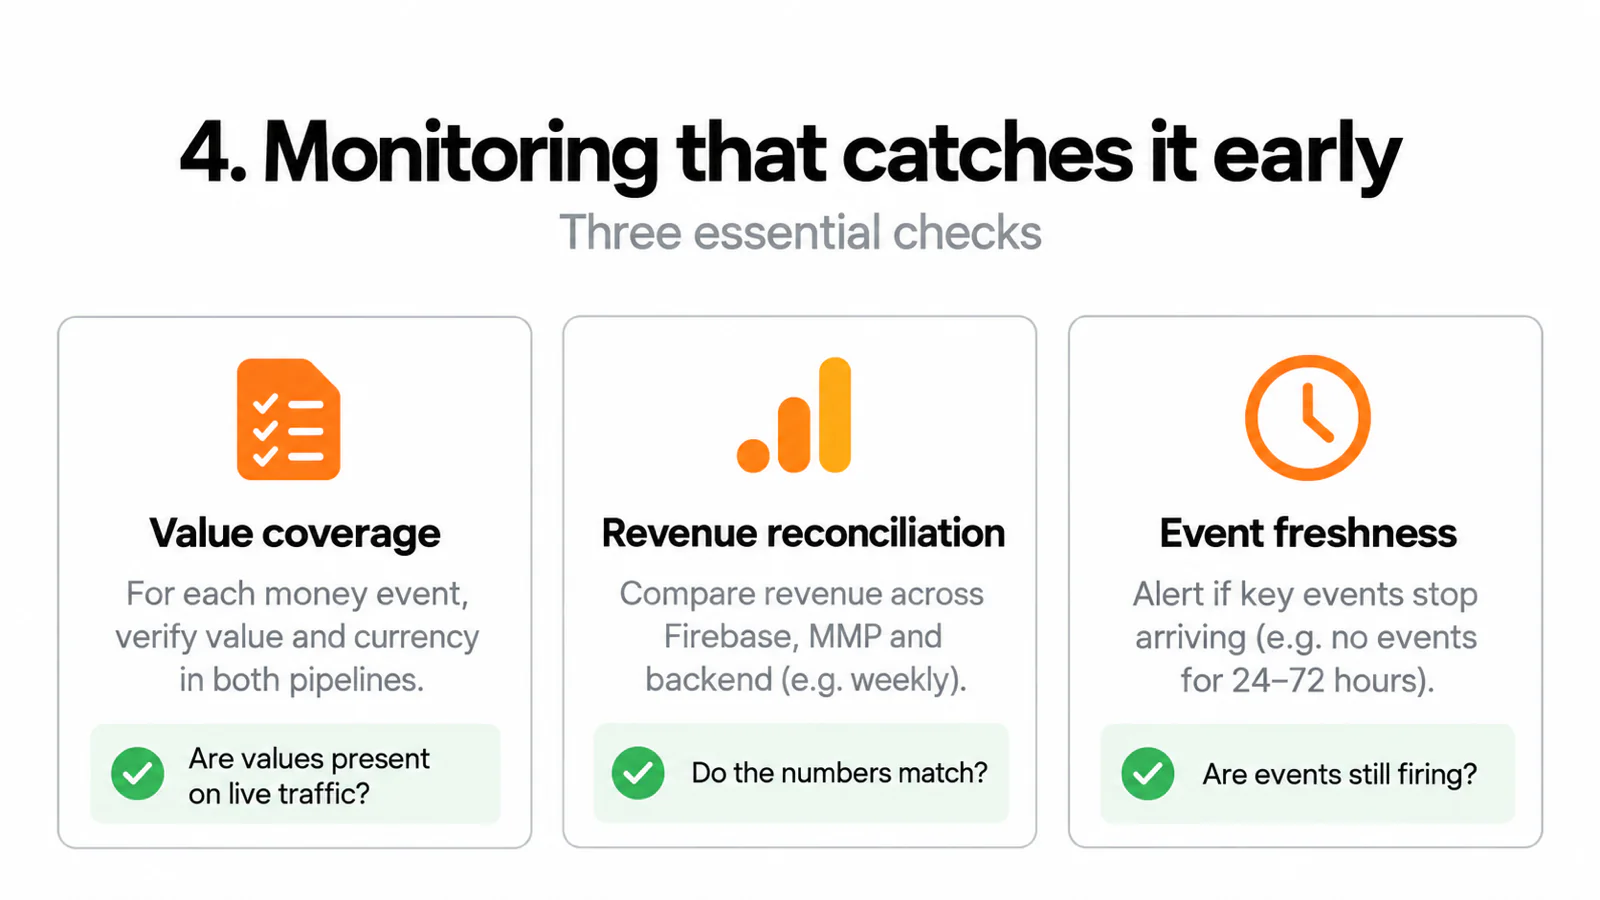
Todo lo anterior se comprime en cinco comprobaciones recurrentes. En un stack pequeño llevan menos de una hora a la semana:
- Cobertura de valor: cada evento con valor lleva valor + moneda, en Firebase y en el MMP, en tráfico real.
- Conciliación entre fuentes: ingresos de Firebase vs MMP vs backend, cada semana, contra una tolerancia acordada de antemano.
- Actualidad de eventos: días-desde-el-último-disparo por evento de conversión, en ambos pipelines. Los eventos muertos son incidentes.
- Ajustes de plataforma: valores de las acciones de conversión, estado principal/secundaria y ventanas de atribución en Google Ads; recepción de evento y valor en el Administrador de eventos de Meta.
- Definiciones de métrica: los dashboards leen “Valor del evento” para eventos personalizados, y cada gráfico indica de qué fuente se nutre.
Nada de esto requiere presupuesto para herramientas. Requiere decidir que el seguimiento es un sistema de producción, y monitorizarlo como tal.
FAQ
¿Cuánta discrepancia de ingresos entre fuentes es normal?
Firebase, un MMP y un backend miden cosas distintas (lógica de atribución, consentimiento, tiempos), así que diferencias del 10-30 % en cortes concretos son habituales. Fija tu propia tolerancia a partir de unas pocas semanas limpias. Los múltiplos, como la diferencia de 8x que sufrimos, son siempre bugs.
¿Por qué no coinciden mis cifras de ingresos de Firebase y Adjust?
Una cierta diferencia es normal, pero un múltiplo es un bug, no un matiz de atribución. Cuando nos pasó, Firebase reportaba unas 8 veces los ingresos que capturaba Adjust, porque el pipeline de Adjust descartaba en silencio valores mal formados (NaN, un string donde se espera un número, o una etiqueta de moneda no ISO) mientras que la llamada directa de Firebase los adjuntaba correctamente. Mira el Fallo 3: concilia ambos contra tu backend cada semana, y si una fuente marca una fracción de la otra, registra el tipo y el valor de los ingresos y la moneda justo antes de la llamada al SDK para encontrar dónde se pierde.
Mi GA4 muestra 0,00 de ingresos en los eventos de app. ¿Roto o no?
Comprueba primero la métrica: los eventos con nombre personalizado informan bajo “Valor del evento”, no “Ingresos totales”. Si “Valor del evento” también es cero, entonces el parámetro de valor falta de verdad y tienes el fallo 2.
¿Por qué el MMP descartó ingresos sin ningún error?
Los SDK de MMP validan la llamada de ingresos y la omiten en silencio cuando la entrada está mal formada: NaN, un string donde se espera un número, o una etiqueta de moneda inesperada. El evento en sí igual llega, que es lo que lo hace invisible.
¿El valor de conversión predeterminado debería ser simplemente cero?
No. Fíjalo cerca de tu media real para que un hueco futuro en el pipeline se degrade con elegancia. Un valor predeterminado de 1,00 en un producto de alto valor es una invitación permanente a la distorsión de las pujas.
¿Quién debería ser responsable de estas comprobaciones?
Quien sea responsable del rendimiento de pago, no ingeniería. Ingeniería arregla los pipelines; el marketing sufre en silencio cuando se rompen. La checklist existe para que la persona que gasta el presupuesto se dé cuenta primero.
Puntos clave
- El seguimiento de ingresos de apps falla en silencio por diseño: los SDK se saltan los valores mal formados sin dar error, y las plataformas pujan tan contentas sobre lo que llega.
- Que un evento llegue no es prueba de que llegó su valor. Audita la cobertura de eventos y la cobertura de valor por separado, en cada pipeline.
- La arquitectura de doble stack significa que cada fallo puede ocurrir dos veces, de forma independiente. Concilia entre fuentes cada semana.
- Los valores predeterminados importan: los valores de conversión, el estado principal/secundaria y las ventanas de atribución dirigen en silencio cada decisión automatizada.
- Trata el seguimiento como un sistema de producción con alarmas de actualidad. Dos meses muertos en un evento son un coste real sin factura.
Lo siguiente en la serie: el fallo específico de iOS que incluso un stack sano tiene ahora mismo, donde iOS genera más compras que Android y Google Ads no atribuye casi ninguna.
Si quieres pasar estas cinco comprobaciones por tu stack una vez, bien hechas, ese es el núcleo de mi auditoría de seguimiento de apps.
Fuentes: experiencia de implementación propia y depuración sobre un stack dual de Firebase + Adjust para un marketplace de reservas suizo (2026); GA4 documentation on revenue metrics; la primera parte de esta serie, ¿Firebase o un MMP?.